


PDF怎么转换成Excel,先看Excel是否支持从PDF导入。如果你的软件里能找到“数据→获取数据→自文件→自PDF”,这通常是整理表格数据时更直接的入口;如果没有这个连接器,再考虑其他转换方式。无论用哪种办法,转完都不能只看“能打开”,还要核对表头、金额、日期和合计。
先判断:你的Excel能不能直接导入PDF
微软官方资料确认,部分Excel环境支持通过 Power Query 从 PDF 获取数据,常见路径是“数据→获取数据→自文件→自PDF”。导入后会出现导航器,可选择表,再决定“加载”或“转换数据”。
但这一步不是所有版本都有。微软同时说明,不同版本、不同授权环境、不同平台,支持的数据连接器并不完全一致,所以不能把“所有Office都能直接导入PDF”当成通用结论。
判断方法很简单,不用先研究PDF类型。按下面顺序检查即可:
- 打开Excel,进入“数据”选项卡。
- 查看是否有“获取数据”或类似入口。
- 继续看“自文件”下面是否存在“自PDF”。
- 如果有,就先走导入流程;如果没有,再换其他方案。
这里还有一个容易误判的点:文字能否选中,只是线索。有些PDF虽然能复制文字,但表格结构未必能被正确识别;尤其是列间距不清、跨页表头重复、单元格里混有换行时,导入后仍可能错列。
能导入时怎么做:从导航器到加载或转换
如果Excel里有“自PDF”入口,操作顺序可以尽量固定,这样后面排错更省事。基础路径如下:
- 在Excel点击“数据→获取数据→自文件→自PDF”。
- 选择目标PDF文件。
- 等待导航器列出可识别的表或页面。
- 先逐个预览,再决定选哪一张表。
- 结构基本正常时点“加载”;如果还需要清洗,选“转换数据”。
“加载”和“转换数据”不要混用。当前预览里如果表头、列分隔、行顺序已经基本正常,直接加载更快;如果你一眼就看到空列、重复表头、列拆分错误,优先进入“转换数据”处理,再送入工作表。
完成判断不能只看“数据进来了”。更实用的标准有三个:第一,字段名能否对应原表含义;第二,同一列的数据类型是否一致;第三,原表中的一行记录,导入后是否仍然占一行。只要这三项有一项明显异常,后续统计就容易出偏差。
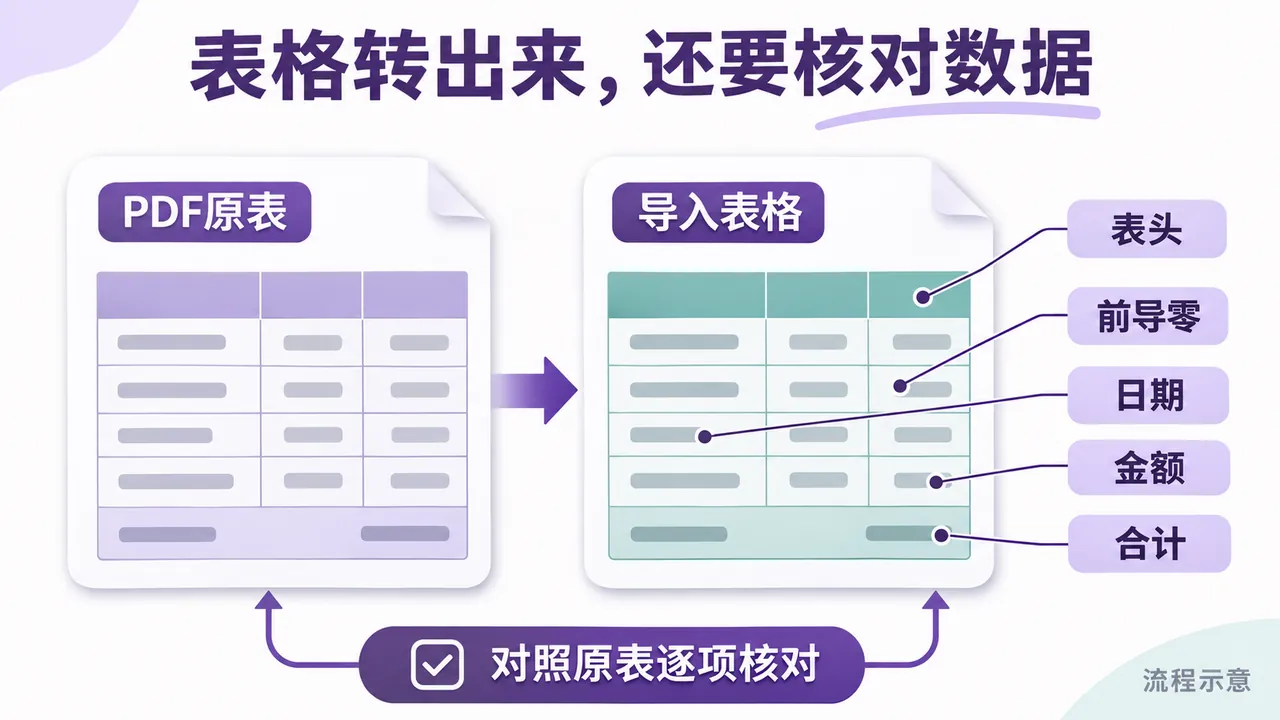
转完别急着交:5个位置最容易出错
PDF转Excel最常见的问题,不是完全无法转换,而是表面看起来成功,实际细节已经变形。下面这5个位置,建议按顺序核对。
1. 表头是否被拆成两行或多行
很多报表的标题区有合并单元格、备注、单位说明。导入后,表头可能变成两行,甚至把“单位:元”识别进数据区。遇到这种情况,先确认哪一行才是真正字段名,再删除多余说明行。
2. 跨页表格有没有重复表头
PDF跨页表格常在每页顶部重复一次表头。导入Excel后,这些重复行可能混在正文中。核对时可以按首列排序或筛选,看看中间是否再次出现“日期、编号、金额”这类字段名;出现了就应清理掉。
3. 前导零有没有丢失
编号、工号、邮编一类字段,经常因为Excel自动识别而丢掉前导零。比如示例:原PDF为“001258”,导入后可能变成“1258”。这类列应尽早改成文本格式,再检查是否需要补回零位。
4. 日期和金额是否被误判
日期可能被拆成文本,金额也可能带着货币符号、空格或括号,导致无法直接求和。可以先抽查几行,再看整列格式是否统一;如果同一列里既有“2024/01/03”又有纯文本,后续筛选和透视表都会受影响。
5. 合计行有没有被重复计算
原PDF里常带“小计”“合计”“本页合计”。这些行如果和明细一起导入,后面再求和时就会重复计算。最稳的做法是先把合计类行单独筛出来,确认保留还是删除,再开始做公式。
如果你只想快速判断这份表能不能继续用,可以先做一个小范围核对:
- 抽查首尾各几行,确认列没有错位。
- 找一条带编号、日期、金额的完整记录,逐项对原PDF。
- 对照原表合计,看Excel汇总是否一致。
这一步比反复换工具更重要,因为很多问题不是“没转出来”,而是“转出来但悄悄错了”。
没有PDF入口怎么办:替代方案和适用边界
如果你的Excel里没有“自PDF”连接器,最现实的处理方式是换一个能做PDF转Excel的入口,再把结果放回Excel核对。这里的重点不是追求一步到位,而是先把表格数据取出来。
这种情况下,可以使用哔果PDF转换器作为可选入口,再回到Excel继续检查字段和格式。使用前仍需查看当前页面的免费额度、文件限制和扫描识别选项;得到表格后,照样要核对字段、格式与合计,不能把转换入口当作免核对方案。
替代方案适合以下场景:
- 当前Excel没有PDF导入入口。
- 只需要先拿到可编辑表格,再做整理。
- 原文件页数不多,人工复核成本可接受。
不适合的情况也要说清楚。涉及复杂跨页报表、列中嵌套换行、格式要求特别严的文件,转换结果往往仍需人工修正。尤其当你要保留原版式时,Excel更适合做数据整理,不适合期待百分百还原PDF视觉布局。
扫描件为什么更要人工核对
扫描版PDF和图片版PDF,难点不在导出按钮,而在识别本身。文字、数字、表格线都可能被误判,所以这类文件即使成功转成Excel,也只能说明“拿到了初稿”,不能直接认定数据无误。
这类文件建议优先关注关键字段,而不是先修样式。按决策顺序看,通常更值得先查的是:
- 编号是否完整,尤其含字母和前导零的列。
- 日期是否统一,避免同列混入文本。
- 金额是否出现少位、多位或小数点错位。
- 合计与明细是否能对上。
如果原表还是跨页扫描,建议按页拆开处理,再合并到同一工作簿中核对。原因很直接:跨页处最容易出现断行、重复表头和漏识别。分开检查后再汇总,通常比一次性整份处理更容易发现问题。
最后容易遗漏的一点是:当你看到PDF中的文字能被选中,不代表表格结构也一定会被准确识别;当你已经拿到Excel文件,也不代表这份数据已经能直接用于汇总。真正决定结果可不可用的,往往是后面的核对,而不是前面的转换动作。