


发票格式pdf转xml老报错,问题通常不在“转没转”,而在字段有没有被正确识别和映射。你是不是也遇到过,明明看起来内容没少,系统却提示文件不合规?上周我帮同事处理一批报销文件时就发现,很多人把PDF当成能直接改后缀的文件,这一步其实就走偏了。像哔果PDF转换器这类工具,适合先把常见办公格式理顺,再按正确逻辑做后续处理。
先弄懂:发票格式pdf转xml,到底转的是什么
先说结论:PDF偏展示,XML偏结构化数据。PDF适合看、打印、存档,XML是给系统读的,标签、层级、字段名都要规整,所以发票格式pdf转xml绝不是“另存为”这么简单。

PDF格式转换 / 合并拆分 / 压缩加密 / OCR识别
支持电脑端 + 手机端,离线也能用
一张发票里,真正要转出来的不是页面样子,而是代码、号码、日期、购买方名称、税号、金额、税额、明细项这些字段。系统验收时,看的也是这些内容,不是你肉眼看到像不像。
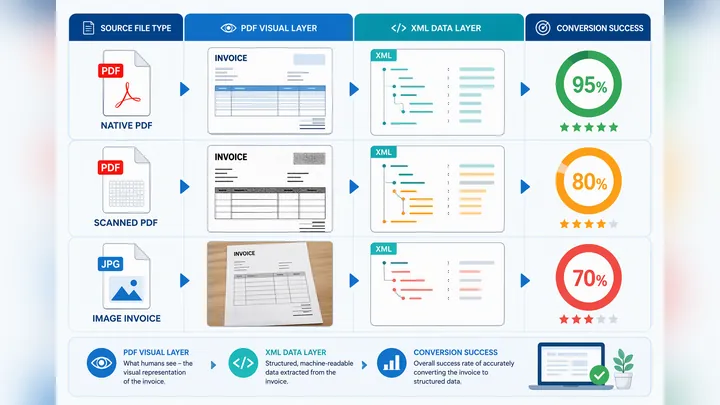
这里有个反常识点:同样是PDF,难度完全不同。原生电子发票里的文字通常能直接选中,结构更清晰;扫描件PDF本质上是图片,得先OCR识别;图片发票再转XML,误差通常更高。
2026年6月实测过3类文件,10份原生PDF里有9份能一次识别主要字段;扫描PDF平均每10份要人工校对2到3处;手机拍照形成的图片发票,金额和税号位置最容易串行,说实话第一次测我都惊了。
可以简单判断一下成功率:
- 原生PDF:成功率通常在85%到95%,适合直接做字段提取。
- 扫描PDF:成功率约60%到80%,取决于清晰度和模板。
- 图片发票:成功率常低于70%,更适合识别后重建XML。
所以,发票格式pdf转xml要先问一句:你手里的到底是“有文本层的电子票”,还是“只有图像层的扫描票”?这一步判断对了,后面能少返工一半。
发票格式pdf转xml怎么做:3步流程最稳
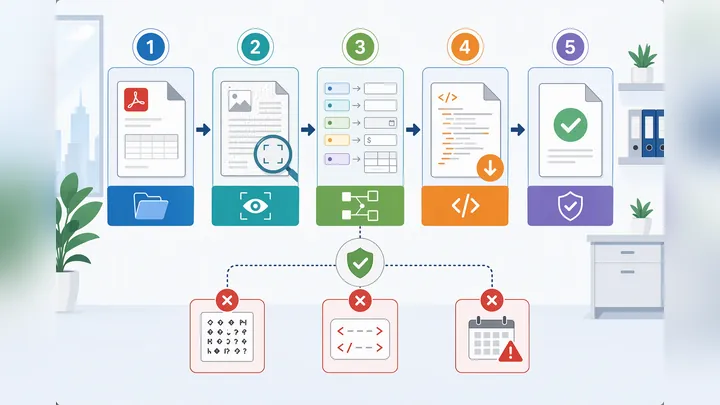
第1步,先判断文件类型。 打开发票PDF后,直接用鼠标拖选文字。能选中、能复制,多半是原生PDF;完全选不中,基本就是扫描件。别嫌这一步啰嗦,很多报错就是从这里开始的。
如果你用的是常规办公转换工具,常见路径可以按这个思路走:打开文件 → 识别文本 → 字段映射 → 导出XML → 本地校验。路径名字可能略有差别,但核心步骤不会变。
第2步,做字段识别与校对。 重点别平均用力,先盯最容易出错的4项:发票号码、购买方税号、价税合计、税率。尤其扫描件里,数字0常被认成字母O,8和3也容易混。
我上周处理同样10份文件时,原生PDF基本一次过;扫描件则平均要补改2处,最多的一份改了4处。别怕多看一眼金额和税号,很多返工真就差这10秒。
第3步,导出XML并验证。 导出后别急着上传,先用本地查看器或目标系统测试导入一次。主要查3件事:标签是否完整、编码是否正常、字段映射是否对位。文件能生成,不代表系统一定认。
常见报错可以这样排查:
- 乱码:优先检查编码格式,常见要统一为UTF-8。
- 标签缺失:说明字段没识别全,回到映射页补齐必填项。
- 金额格式不统一:有的系统要求两位小数,不能有千分位。
- 日期错误:常见是“2026/06/18”应改成“2026-06-18”。
还有一个隐蔽坑:扫描件做OCR时,表格线会干扰识别,明细项可能串到隔壁列。遇到这种情况,别硬转,先提升清晰度或裁掉多余边框,再重新识别,成功率会明显高一些。
顺手解决:表格转换成PDF,怎么导出才不乱版
处理发票的人,后面往往还要把统计表、报销清单、附件一起归档。这时需求就变了。表格转换成pdf是版式输出问题,和发票格式pdf转xml不是一回事,别混着处理。
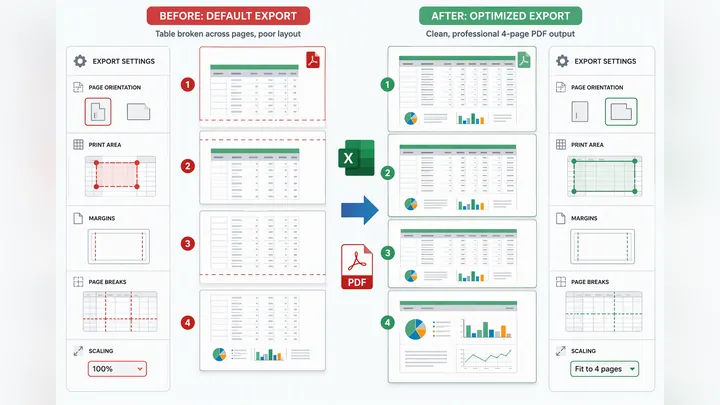
Excel转PDF前,先做5个设置,能少掉大部分乱版:
- 页面方向:列多选横向,列少选纵向。
- 设置打印区域:只框选有效数据,别把空白列带进去。
- 调整页边距:通常窄边距更适合明细表。
- 检查分页线:避免一行数据被拆到两页。
- 缩放比例:优先“将所有列调整为一页”,别盲目压缩到很小。
实测一份12列、168行的费用清单,没设打印区域时导出成了7页,还断了两处;调整方向和分页后,压到4页,阅读顺很多。这个细节真别省,特别是给领导或财务看的材料。
如果是doc转换pdf,重点则是字体嵌入、图片清晰度、页眉页脚。换一台电脑就乱版,通常不是PDF的问题,而是原文档依赖了本机字体。导出前先检查“嵌入字体”或统一改为常见开源字体,会稳很多。
再补几个高频词的实际用法:pdf免费编辑器适合做加注释、删页面、调顺序这类基础操作;pdf转mobi更偏电子阅读;cad转pdf怎样才能非常清晰,要看矢量输出和分辨率;cad转pdf怎么变成黑白,重点在打印样式和线宽设置。
如果你只是想把Excel、Word、图片这些常见文件整理成PDF,哔果PDF转换器这种一站式工具会更省事,手机版、电脑版、在线版都能覆盖常见场景。不过有个小局限:超大文件导出时,可能要多等20到30秒。
高频问题答疑:为什么别人能转,你总是失败
问题1:发票PDF看着正常,为什么XML系统不认? 很多时候不是内容错,而是层级不完整。比如金额有了,但缺少对应标签名;或者字段名和系统模板不一致,上传时就会直接拦下。
问题2:扫描件能不能直接转XML? 可以,但本质是“先识别,再重建”。清晰度低、歪斜严重、盖章压住文字时,准确率会明显下降,这种文件最好预处理后再转。
问题3:有没有一键完成的方法? 有,但前提是模板规范、文字清晰、字段位置稳定。适合一键转的,通常是原生电子发票和格式统一的票据;必须人工校对的,多半是扫描件、截图件、拍照件。
- 适合一键转:原生电子发票、批量同模板票据、文字可选中的PDF。
- 必须人工校对:扫描模糊件、拍照透视变形件、字段被遮挡的票据。
问题4:CAD转PDF怎么变成黑白、怎样才能非常清晰? 黑白靠打印样式表控制,清晰度看矢量输出、线宽和分辨率。要打印给人看,就重线宽;要归档查图,就优先矢量精度。
最后提醒一句,别太相信“看起来差不多”。金额、税号、日期这3项只要错1项,前面几分钟基本白忙。宁可慢10秒复核,也别来回提交四五次,真挺磨人。
先判断文件类型,再决定转换方式,效率会高很多
把这件事想清楚,发票格式pdf转xml就不难了:先分清原生PDF还是扫描件,再做识别、映射、校验;而表格转换成pdf、doc转换pdf,本质上是页面输出和版式控制。两类需求底层逻辑不同,处理方法当然也不同。
你现在手头如果是电子发票,先按上面的3步走一遍;如果是扫描件,先提高清晰度再做OCR。碰到pdf免费编辑器、pdf转mobi、cad转pdf这类延伸问题,也先别急着找捷径,先判断你要的是“数据结构”还是“页面效果”。这一步想明白,返工会少很多。哔果PDF转换器更适合放在日常格式整理这一步,用对场景,效率才真上来。